Покрытие словаря — это доля слов текста, которые читатель уже знает, и один из самых сильных предикторов того, поймёт ли он прочитанное. Десятилетия исследований, начиная с работы Лауфер и Равенхорст-Каловски о лексическом пороге, сходятся на двух практических ориентирах: 95 % покрытия как минимальный уровень и 98 % как уровень, при котором читать комфортно и без посторонней помощи. В пересчёте на словарный запас это примерно 4000–5000 словарных семей для нижней планки и около 8000 для верхней.
Коротко:
- Первая тысяча самых частотных словарных семей покрывает около 72 % большинства текстов и облегчает базовое понимание.
- Для покрытия в 95 % нужно примерно 4000–5000 словарных семей, для 98 % — около 8000, и от этого зависит, насколько гладко идёт чтение.
- Восприятие на слух и аудиовизуальное понимание обычно терпят более низкое покрытие, чем чтение, потому что контекст и интонация компенсируют незнакомые слова.
- Покрытие измеряют, разбивая текст на слова и сопоставляя их с частотными списками, но на коротких образцах до 200 слов оценка ненадёжна.
- В обучении и оценке цели по покрытию должны различаться: 95 % для экстенсивного чтения и чтения ради удовольствия, 98 % для ответственных академических и технических текстов.
Содержание
- Что такое покрытие словаря в тексте
- Как пороги различаются в разных исследованиях
- Как покрытие измеряют на практике
- Что пороги покрытия значат для обучения и оценки
- Где метрики покрытия не справляются
- Практический чек-лист: как измерить покрытие и что с ним делать
- Источники
- Частые вопросы
Что такое покрытие словаря в тексте
Покрытие словаря показывает, какую долю слов текста читатель узнаёт, и выражается в процентах от общего числа словоупотреблений, а не уникальных слов. Исследователи считают его так: берут текст, разбивают на отдельные слова и сверяют каждое с частотным списком или с профилем известной лексики конкретного читателя или группы учащихся.
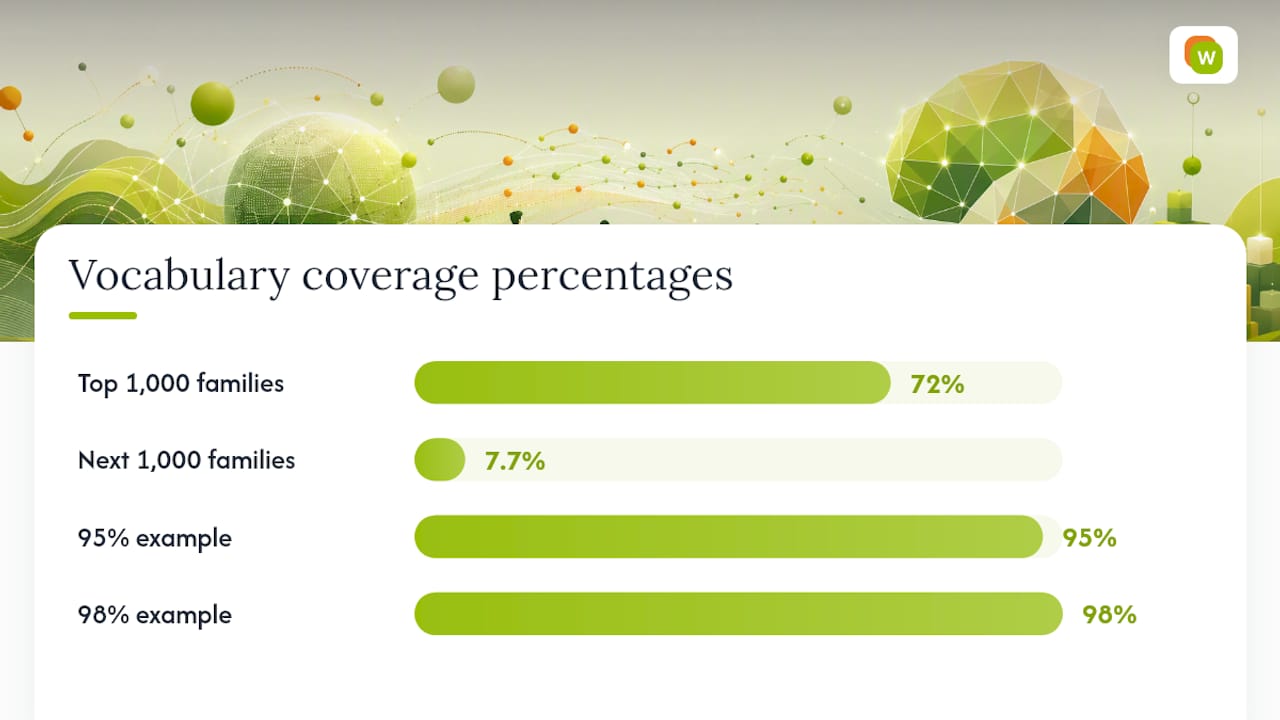
Арифметика здесь обманчиво проста, а закономерность, которую она вскрывает, — нет. Частотность слов в любом языке подчиняется распределению Ципфа: небольшое число слов составляет огромную долю любого текста. Поэтому первая тысяча самых частотных словарных семей покрывает около 72 % типичного текста, а следующая тысяча добавляет лишь около 7,7 процентного пункта. Прирост покрытия быстро сокращается по мере движения вниз по частотному списку, и именно поэтому закрыть последние несколько процентов до 98 % требует намного больше словарных семей, чем закрыть первые 70 %.
Небольшой пример делает это наглядным:
- Статья на 500 слов, из которых читатель знает 475, имеет покрытие 95 %: незнакомо примерно одно слово из двадцати.
- Та же статья при покрытии 98 % содержит всего 10 незнакомых слов — примерно одно из пятидесяти.
- Эти пять слов разницы между 95 и 98 % — как раз то место, где чтение из «посильного, но трудоёмкого» становится «гладким».
Как пороги различаются в разных исследованиях
Цифры 95 и 98 % — не результат одного исследования, а закономерность, которая повторяется в целом корпусе работ, хотя за ней стоит реальный разброс. Основополагающее исследование Лауфер и Равенхорст-Каловски установило оптимальный порог на уровне 98 % покрытия, что соответствует примерно 8000 словарных семей с учётом имён собственных, и минимальный порог на уровне 95 %, ближе к 4000–5000 семей.
Другие работы полезно усложняют картину. Исследование доли известных слов в тексте и понимания прочитанного находит в целом положительную, ступенчатую связь между долей известных слов и результатами понимания, а не резкий обрыв на каком-либо пороге, и предлагает 98 % как разумную цель именно для академических текстов. Эта ступенчатость важна: покрытие работает скорее как регулятор, чем как выключатель, и понимание растёт постепенно с ростом покрытия, а не переключается внезапно на одном числе.
Объём словаря за порогами: 95 % покрытия для многих общих текстов соответствует примерно 4000–5000 словарных семей, а для 98 % обычно нужно около 8000, согласно исследованиям лексического порога.
Имеет значение и канал восприятия. Восприятие на слух и аудиовизуальное понимание обычно терпят более низкое покрытие, чем чтение, потому что интонация, картинка и контекст берут часть нагрузки на себя, тогда как плотная академическая проза обычно требует покрытия у верхней границы диапазона, чтобы просто оставаться читаемой.
Как покрытие измеряют на практике
Стандартный порядок — лексическое профилирование, и оно идёт в три шага. Сначала текст разбивается на отдельные слова. Затем каждое слово сопоставляется со словарной семьёй в частотном списке: знание слова «run» засчитывается как частичное знание «running», «runner» и «ran». Наконец, скрипт подсчитывает, какую долю всех словоупотреблений покрывает известная читателю лексика.
Инструменты для этого:
- Vocabulary Profile и English Vocabulary Profile, которые сопоставляют слова с частотными диапазонами и уровнями CEFR для сверки с известным учащемуся набором.
- Частотные списки, построенные на больших корпусах, таких как Британский национальный корпус или COCA, которые и задают, что вообще значит «частотный» в данном языке.
- Новые подходы с участием языковых моделей, которые оценивают знание слова в контексте, а не по статическому списку; это помогает с многозначностью, ведь слово вроде «light» значит разное в зависимости от окружающего предложения.
Совет: Показатели покрытия надёжны ровно настолько, насколько надёжен образец, на котором они посчитаны. Не сообщайте покрытие для текстов короче 200 словоупотреблений: на коротких образцах оценка сильно скачет из-за горстки редких слов. Если короткий текст неизбежен, усредняйте по нескольким образцам, а не доверяйте одной цифре.
Вторая тихая ловушка — устойчивые сочетания. Инструмент на правилах, который засчитывает «kick the bucket» как три известных по отдельности слова, завысит реальное понимание этого предложения.
Что пороги покрытия значат для обучения и оценки
Цели по покрытию должны меняться в зависимости от того, чего на самом деле добивается урок или проверка, и считать 95 и 98 % взаимозаменяемыми значениями по умолчанию — распространённая ошибка.
- Берите 95 % для понятного ввода и экстенсивного чтения. Когда цель — объём, удовольствие и попутное усвоение лексики, а не полное понимание, нижняя планка в 95 % держит тексты сложными, но не перегружает читателя. Это территория экстенсивного чтения как формы занятий.
- Оставьте 98 % для самостоятельного ответственного чтения. Научные статьи, экзаменационные тексты и технические материалы, как правило, требуют верхней планки, потому что рядом нет ни преподавателя, ни контекста, который закроет пробелы в понимании.
- Выбирайте тексты осознанно. Адаптированные книги могут дать 98 % покрытия уже при 3000 словарных семьях, тогда как неадаптированным романам или газетным текстам часто нужно от 8000 до 14 000 семей, чтобы достичь того же потолка, так что выбор текста значит больше, чем принято думать.
- В обучении отдавайте приоритет лексике второго уровня. Академические слова, общие для многих предметов, дают наибольший прирост покрытия на час занятий — больше, чем редкие технические термины или уже знакомые слова первого уровня. Подробнее об этом — в материале о приоритетах понимания и словаря.
- Сочетайте покрытие с проверкой узнавания в контексте. Голый процент покрытия говорит о том, что читатель, вероятно, знает; задание по образцу подхода ROAR-Written Vocabulary показывает, может ли он действительно извлечь значение в контексте, а это и есть настоящая цель.
Где метрики покрытия не справляются
Покрытие предсказывает понимание, но не гарантирует его. Несколько оговорок удерживают цифры в рамках честности:
- Даже при высоком покрытии читатель может ничего не понять, если незнакомые 2 % — это плотные, нагруженные смыслом термины, а не служебные слова.
- Короткие тексты, обилие многозначности и устойчивые сочетания снижают надёжность отдельной оценки покрытия, и об этом говорят исследования ограничений лексического профилирования.
- Индексы разнообразия вроде отношения типов к токенам или MATTR полезны как дополнительные меры сложности текста, но они неустойчивы на коротких образцах и не заменяют покрытие, когда вопрос стоит о понимании.
- Значительная часть классической литературы о порогах опирается на скромное число исследований, поэтому считать 95 и 98 % универсальными законами, а не полезными приближениями, значит приписывать данным больше, чем они подтверждают.
Прозрачное описание метода — тип текста, длина образца и использованный эталонный корпус — важнее, чем признаёт большинство работ.
Практический чек-лист: как измерить покрытие и что с ним делать
Исследователям и преподавателям полезнее повторяемая последовательность, чем беглый взгляд на процент.
- Выберите репрезентативный образец текста — в идеале не меньше 200 словоупотреблений и того жанра, который вас действительно интересует.
- Выберите частотный список или инструмент профилирования и укажите, какой именно: оценки покрытия меняются в зависимости от того, взят ли список на основе BNC или другого корпуса.
- Проведите разбиение на слова и подсчёт покрытия, учитывая словарные семьи, а не отдельные словоформы.
- Сообщайте метод вместе с числом. Тип текста, длина образца и источник корпуса должны быть в описании, а не только итоговый процент.
- Сопроводите показатель покрытия проверкой понимания — тестом с пропусками, пересказом или заданием на узнавание в контексте.
- Действуйте по результату. Если покрытие ниже 95 %, заранее разберите ключевую лексику или замените текст; если выше 98 %, можно давать самостоятельное чтение.
Совет: Когда вы следите за собственным уровнем чтения, а не проводите формальное исследование, инструмент вроде расширения WordByWord покажет уровень понимания страницы ещё до того, как вы возьмётесь за чтение, — та же логика, что у расчёта покрытия, только в реальном времени, а не постфактум. Для занятий в группе руководство WordByWord по учёту слов во время чтения описывает похожий порядок шаг за шагом.
Показать учащемуся его уровень понимания до начала текста — то же самое, что рассчитать лексическое покрытие, только быстрее и в контексте. Режим Spotlight подсвечивает незнакомые слова прямо на странице и делает видимым разрыв между тем, что читатель знает, и тем, чего требует текст. При этом данные расширения о том, что знает один учащийся, — полезный сигнал для ежедневных учебных решений, а не замена контролируемым исследованиям порогов. Эти два источника должны дополнять друг друга, а не подменять.
— Команда WordByWord
Источники
- Lexical threshold revisited: Lexical text coverage, learners’ vocabulary size and reading comprehension
- Research Investigating Lexical Coverage and Lexical Profiling: What We Know, What We Don’t Know, and What Needs to be Examined
- ROAR-Written Vocabulary (ROAR Comprehension Suite) — instrument description
Частые вопросы
Как найти в тексте слова для изучения?
Пропустите текст через инструмент лексического профилирования, например Vocabulary Profile, который разбивает текст на слова и отмечает те, что выходят за пределы частотных диапазонов, или сверьте его вручную с частотным списком, чтобы увидеть, какие слова лежат за границей известной читателю лексики.
Какие бывают основные типы структуры текста?
В исследованиях чтения обычно выделяют описание, последовательность, причину и следствие, сравнение и противопоставление, проблему и решение; некоторые схемы добавляют повествование как отдельную шестую или седьмую категорию, хотя определения в разных источниках различаются.
Можно ли привести примеры слов по уровням частотности?
Высокочастотные примеры — «the», «make», «get»; среднечастотные академические — «significant», «factor», «analyze», «context»; низкочастотные или технические — «morpheme», «corpus», «lexeme», «polysemy». Каждая группа взята из своего диапазона частотного списка.
Какие виды словаря отслеживают преподаватели?
В исследованиях словаря слова обычно делят на лексику аудирования, говорения, чтения и письма, иногда с пятой категорией — зрительным словарём; это отражает то, что рецептивный словарь учащегося (слова, которые он понимает) обычно больше продуктивного (слов, которыми он пользуется).
Какая цель лучше для изучающих язык — 95 или 98 %?
Зависит от задачи: 95 % покрытия хорошо подходят для экстенсивного чтения и понятного ввода, а 98 % — для самостоятельного чтения сложных академических и технических текстов, согласно выводам Лауфер и Равенхорст-Каловски.