Работа с субтитрами устроена так: вы берёте предложения прямо из субтитров к видео и превращаете те из них, где незнакомо ровно одно слово, в карточки для интервальных повторений. Быстрее всего начать так: откройте файл или дорожку субтитров к тому, что вы и так смотрите, найдите строку, в которой понимаете всё, кроме одного слова или выражения, и сохраните в систему повторений это предложение целиком, а не одно слово.
Коротко:
- Качество субтитров и правильное деление на строки напрямую влияют на то, годятся ли собранные предложения для учёбы и запоминания.
- Отсев частотных и уже известных вам слов разгружает повторение и оставляет только действительно новую лексику.
- Инструменты, встроенные в браузер, объединяют извлечение, чистку и создание карточек в один шаг.
- Лучше всего подходит контент, который вы понимаете примерно на 80–90 %: тогда новые слова заметны, а материал ещё посилен.
- Аудиофрагмент и картинка в карточке помогают с произношением и контекстом и делают повторение полезнее.
Содержание
- Что такое работа с субтитрами и почему важно правило одной цели
- Какие форматы субтитров и инструменты на самом деле нужны
- Как извлечь и почистить субтитры перед работой
- Пять шагов работы с субтитрами
- Как ошибки тайминга и деления строк портят результат
- Как WordByWord упрощает работу с субтитрами
- Можно ли автоматически отсеивать уже известные слова
- Не только Anki: другие способы повторять собранные карточки
- Субтитры с несколькими языками или диалектами
- Как выбрать подходящий контент
- Какой должна быть хорошая карточка из строки субтитров
- Ручная цепочка инструментов или единое приложение: что выбрать
- Начните работать с субтитрами без лишних шагов
- Источники
- Частые вопросы
Что такое работа с субтитрами и почему важно правило одной цели
Сбор предложений из субтитров — целенаправленная альтернатива пассивному чтению субтитров. Чтение вместе с субтитрами даёт контакт с языком, но не заставляет ничего запоминать. Сбор заставляет, потому что вы вынимаете конкретные предложения и осознанно повторяете их потом.
Метод держится на правиле, которое называют 1T — «одна цель». Вы берёте предложения, в которых незнакомо ровно одно слово или выражение, а всё остальное понятно. Так нагрузка остаётся достаточно низкой, чтобы мозг привязал новое к контексту, а не тонул одновременно в незнакомой грамматике и лексике. Опытные ученики годами опираются на это правило, потому что оно ускоряет создание карточек и делает запоминание надёжнее: личный материал с богатым контекстом работает лучше готовых списков слов для большинства людей.
Три вещи делают собранные предложения прочнее словарных статей:
- Контекст: слово приходит вместе с грамматикой, интонацией и ситуацией, а не висит в пустоте.
- Личная значимость: вы выбрали предложение, потому что уже были увлечены содержанием.
- Интервальные повторения: повторение через растущие промежутки закрепляет предложение в долгой памяти, а не оставляет на уровне узнавания.
Ничего из этого не работает, если само предложение искажено, и здесь качество субтитров становится настоящей переменной, а не примечанием.
Какие форматы субтитров и инструменты на самом деле нужны
Вам встретятся два типа субтитров, и обращаться с ними нужно совершенно по-разному.
Внешние субтитры — это отдельные текстовые файлы или встроенные текстовые дорожки. SRT — самый старый и простой формат, VTT распространён в веб-видео и на YouTube, а ASS поддерживает оформление и позиционирование и часто используется в любительских переводах аниме. Все три внутри — обычный текст, а значит, их можно открыть в любом текстовом редакторе, искать по ним и копировать строки прямо в карточку.
Вшитые субтитры впечатаны прямо в изображение. Текстового слоя, который можно скопировать, нет. Если текст субтитров нельзя выделить или найти поиском, он вшит, и чтобы получить редактируемый текст, понадобится распознавание.
Для навигации нужен видеоплеер, который показывает тайм-коды субтитров, чтобы вернуться к строке, проверить произношение или вырезать фрагмент. Этого достаточно. Специальное приложение на этом шаге не требуется.
Особенности форматирования, которых стоит ждать в любом формате:
- Описания звуков в скобках вроде «[скрипит дверь]», которые не являются репликами.
- Имена говорящих («ДЖОН:») в начале строки.
- Теги оформления (курсив, коды цветов), оставшиеся от исходного файла.
- Предложения, разбитые на два-три блока субтитров, которые нужно склеить, чтобы они читались естественно.
Как извлечь и почистить субтитры перед работой
Сначала проверьте, есть ли у источника настоящая дорожка субтитров. Большинство стриминговых сервисов и скачанных видеофайлов её показывают, если она есть. Если субтитры можно включить и выключить, а текст остаётся чётким независимо от сжатия видео, это внешние субтитры. Если при выключении они исчезают полностью или отдельной дорожки в файле нет, перед вами вшитые.
Для вшитого текста стандартный порядок распознавания выглядит так:
- Сохранить кадры видео при каждой смене субтитров.
- Пропустить кадры через движок распознавания текста.
- Преобразовать распознанный текст в формат SRT или VTT.
- Выровнять тайм-коды по исходному видео, чтобы строки совпадали со звуком.
Современные конвейеры распознавания справляются с этим неплохо на чётком видео: некоторые движки сообщают о точности около 99 % на хорошо снятых кадрах, хотя пёстрый фон, стилизованные шрифты и низкое разрешение быстро снижают эту цифру.
Для внешних субтитров чистка означает удаление описаний в скобках, имён говорящих и остатков оформления, а также склейку или разбивку строк, чтобы каждая читалась как законченное предложение, а не обрывок.
Совет: Прежде чем доверять целому файлу, сверьте пять секунд звука с распознанным текстом. Одна несовпадающая строка в начале обычно означает проблему со шрифтом или контрастом, которая затронет весь файл.
Пять шагов работы с субтитрами
Вот последовательность, которая превращает видео в учебный материал, не съедая весь вечер.
- Извлеките или откройте субтитры. Загрузите внешнюю дорожку, если она есть, или сначала распознайте вшитые. В любом случае получите текст в редактируемом виде, прежде чем снова возвращаться к видео.
- Почистите и приведите строки в порядок. Уберите скобки со звуками, имена говорящих и лишнее оформление, чтобы каждая строка читалась как естественное предложение, а не обрывок субтитра.
- Отберите предложения по правилу одной цели. Ищите строки ровно с одним незнакомым словом или выражением и записывайте тайм-код, чтобы потом вытащить звук или снимок экрана.
- Соберите карточку. Включите предложение целиком, целевое слово в виде пропуска, аудиофрагмент или снимок с этого тайм-кода и метку с названием видео.
- Повторяйте ежедневно и следите за результатом. Интервальные повторения работают, только если вы действительно их выполняете, поэтому пять-десять минут повторения в день — обязательная часть.
Несколько вещей делают этот цикл посильным, а не изматывающим:
- Ограничьте каждый сеанс 8–12 новыми словами. Больше — и очередь на повторение переполнится за неделю.
- Не собирайте каждое незнакомое слово из сцены. Берите те, что кажутся полезными или повторяются.
- Сохраняйте тайм-код, даже если он не нужен сразу. Он понадобится, когда карточка начнёт проваливаться на повторении.
Тот же цикл, подстроенный специально под YouTube, описан в разборе занятия на 5–10 минут: с одного ролика можно собрать хорошую порцию слов, не сбивая просмотр.
Как ошибки тайминга и деления строк портят результат
Неудачное деление на строки портит предложения ещё до того, как дело доходит до лексики. Когда строка субтитров обрывается посреди оборота или предложение разбито на два блока с двухсекундной паузой, вы собираете половину мысли вместо пригодного примера.
Исследователи создали метрику SubER именно потому, что простая точность текста эту проблему не ловила. SubER объединяет правки текста с ошибками деления и тайминга, и оценка людьми показывает, что она отражает реальные усилия на исправление гораздо лучше, чем один только процент ошибок в словах. Смежные работы подтверждают: метрики, учитывающие тайминг, сильнее связаны с трудозатратами на исправление субтитра, чем те, что сверяют только текст с эталоном. Для того, кто учит язык, это значит прямо: по строке с неверным таймингом или плохим делением труднее учиться, а не только труднее её править.
Во время просмотра обращайте внимание на такие признаки:
- Предложение резко обрывается и продолжается в следующем блоке со странной паузой между ними.
- Субтитры появляются заметно раньше или позже соответствующей речи.
- Автоматические субтитры, в которых текст не совпадает с тем, что на самом деле сказано.
Небольшие сдвиги по времени стоит исправить, сдвинув тайм-код. Разбитые предложения стоит склеить в одну карточку. Но если строка искажена до неузнаваемости, особенно в автоматических субтитрах, откажитесь от неё и переходите к следующей, а не собирайте мусор.
Как WordByWord упрощает работу с субтитрами
Ручной сбор работает, но складывается из нескольких отдельных шагов: извлечение, чистка, отбор предложений, сборка карточек и расписание повторений, возможно, в разных приложениях. WordByWord сводит большую часть этого к одному действию в браузере.
- Перевод на странице: нажмите на любое незнакомое слово прямо в субтитрах YouTube, на сайте или в PDF и сразу получите перевод более чем на 50 языках.
- Сохранение в коллекцию: предложение и слово сохраняются вместе автоматически, и вам не нужно вручную копировать текст из файла субтитров.
- Создание карточек: сохранённое превращается в карточки с озвучкой, готовые к интервальным повторениям без отдельной выгрузки.
- Режим Spotlight: подсвечивает слова на странице по тому, насколько хорошо вы их знаете, и вам не приходится выискивать единственное незнакомое слово в длинном предложении.
- Уровень понимания: показывает, какую долю лексики видео вы уже знаете, прежде чем вы потратите на него время.
Бесплатный тариф позволяет попробовать этот порядок работы с ограничениями по объёму, а Premium снимает их для тех, кто ежедневно работает с субтитрами на нескольких языках.
Можно ли автоматически отсеивать уже известные слова
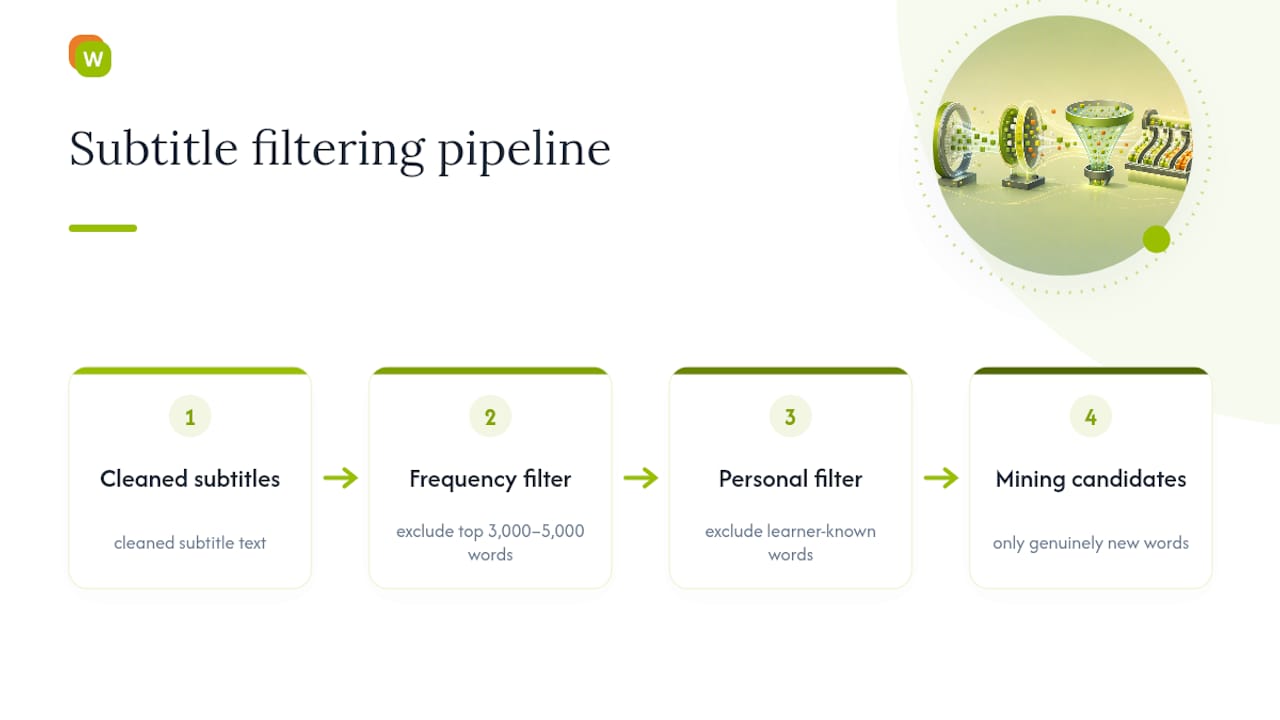
Просматривать вручную каждую строку субтитров в поисках незнакомых слов надоедает уже к третьей серии за день. Отсев по частотности решает это: текст субтитров сравнивается с частотным списком изучаемого языка — ранжированным списком, который лингвисты строят по большим корпусам текстов, — и отмечаются только слова за пределами нескольких тысяч самых употребительных.
Логика простая: частотные слова — служебные, базовые глаголы, повседневные существительные — встречаются постоянно, и если вы вообще смотрите контент для носителей, большинство из них вы уже знаете. Отсеяв их, вы направляете внимание на слова, которые действительно стоит сохранить, а не отмечаете «и», «потому что» или «пошёл» в сотый раз.
Простую версию такого фильтра легко собрать самому в таблице: вставьте почищенный файл субтитров, сверьте с частотным списком и отсортируйте по рангу. Всё, что выходит за ваш порог — скажем, за первые 3000–5000 слов для среднего уровня, — становится кандидатом на сохранение. Всё внутри порога пропускается автоматически.
Более продвинутые конвейеры добавляют второй слой фильтра: ваш собственный список известных слов из уже сохранённой или отмеченной как выученная лексики. Это важно, потому что частотный список универсален. Он не знает, что именно вы три недели назад выучили редкое слово из другого сериала. Именно сверка с вашей личной историей слов, а не только с общим частотным списком, и защищает от повторного сбора.
Здесь у единого инструмента есть настоящее преимущество перед таблицей. Программа, которая уже знает вашу историю слов, как оценка уровня понимания в WordByWord, может отмечать только действительно новые для вас слова, а не просто статистически редкие, и убирает ручной отсев целиком.
Не только Anki: другие способы повторять собранные карточки
В разговорах о сборе предложений доминирует Anki, но это не единственная система интервальных повторений, которой стоит пользоваться, и не всем она подходит лучше всего.
Мобильные приложения с интервальными повторениями снижают порог ежедневного повторения: сеанс в очереди к кассе случается чаще, чем открытая колода на компьютере. Для карточек из субтитров особенно важна поддержка звука: карточка без исходного аудиофрагмента теряет заметную часть учебной ценности. Если ваш источник — диалоги, отдавайте предпочтение любому приложению, где звук можно прикрепить и воспроизвести прямо на карточке, а не только текст и картинки.
Некоторые разделяют процесс полностью: собирают и чистят предложения в одном месте, а готовые карточки выгружают в то приложение для повторения, которым им действительно нравится пользоваться каждый день. Обычный мост здесь — выгрузка и загрузка CSV. Если инструмент для сбора выдаёт таблицу со столбцами предложение, целевое слово и аудиофайл, большинство приложений с интервальными повторениями примут её с минимальными правками.
Но более важный сдвиг — перенести сбор и повторение в одно приложение, вместо того чтобы считать их двумя отдельными инструментами. Карточки WordByWord поддерживают озвучку и семь режимов тренировки, включая ввод с клавиатуры, аудирование и спринт на 60 секунд, по автоматическому интервальному графику, так что предложение, сохранённое во время просмотра, сразу встаёт в вашу очередь повторений без отдельной выгрузки. Собранные так коллекции можно также загружать из CSV, Anki или Quizlet и выгружать в них, если нужно переносить лексику между системами.
Какое бы приложение вы ни выбрали, решающим должно быть одно: будете ли вы открывать его каждый день. Идеальный алгоритм повторений бесполезен, если приложение раздражает настолько, что вы пропускаете три дня подряд.
Субтитры с несколькими языками или диалектами
Файлы субтитров со смешанными языками или диалектными вариантами ломают больше рабочих процессов, чем большинство ожидает. Двойные субтитры, где одновременно показаны изучаемый и опорный языки, распространены на платформах для изучения языков и по-настоящему полезны, чтобы проверить значение, прежде чем отправлять предложение в карточку.
Но смешанные файлы создают конкретный риск: случайно собрать не тот язык. Если дорожка чередует изучаемый язык с английскими пояснениями или стандартный диалект с региональным, помечайте карточки языком источника сразу, а не после того, как накопите пятьдесят карточек, которые теперь нужно разбирать.
Диалектные различия важны даже внутри одного языка. В латиноамериканских и европейских испанских субтитрах разные слова для обычных предметов, разные формы второго лица, а иногда и совсем другой ритм фразы. Если вы собираете из контента на одном диалекте, а готовитесь к другому, отметьте это на карточке. Иначе вы однажды усомнитесь в «неправильном» ответе на повторении, который на самом деле был просто региональным вариантом.
Тем, кто учит несколько языков сразу, стоит держать один язык на сеанс: так не сбиваются частотные фильтры и не путается, с каким списком известных слов идёт сверка. Если вы смотрите сериал с двойными субтитрами, собирайте из дорожки изучаемого языка, а опорную используйте только для проверки значения, а не как основной текст.
Региональный сленг и переключение между языками внутри одной реплики, обычные для многоязычных регионов и медиа с большой долей иммигрантов, стоит собирать осознанно, а не пропускать. Это ровно та лексика, которую частотный список не отметит, а носители используют постоянно.
Как выбрать подходящий контент
Не каждое видео стоит разбирать. Лучший материал близок к вашему уровню понимания: в идеале это видео, в котором вы и без субтитров понимаете 80–90 % сказанного, чтобы незнакомые слова выделялись, а не тонули в незнакомой грамматике поверх незнакомых слов.
Уровень понимания важнее жанра. Детский мультфильм на изучаемом языке может оказаться лучшим источником, чем престижная драма, если в драме диалоги плотные и быстрые. Проверка уровня понимания до просмотра, а не догадка по обложке, спасает от брошенных на половине серий, которые оказались не по силам.
Второй фильтр — интерес к теме. Когда вы собираете лексику из того, что вам действительно интересно, вы помните, зачем сохранили слово, и это усиливает ту самую личную значимость, благодаря которой предложения работают лучше обычных списков. Кулинарное шоу даёт слова о еде, которыми вы будете пользоваться; документальный фильм о преступлениях — юридическую лексику, к которой вы, возможно, больше не вернётесь.
Практические критерии перед началом сеанса:
- Чистота звука: невнятная речь и сильный акцент затрудняют и распознавание, и ручную расшифровку.
- Наличие субтитров: убедитесь, что настоящая дорожка есть, особенно у старого или нишевого контента.
- Длина серии: короткие ролики (10–20 минут) легче разобрать целиком без усталости, чем двухчасовой фильм.
- Сериальный формат: серии позволяют наращивать словарь постепенно и закреплять ранее собранные слова в новых контекстах.
Если вы работаете именно с YouTube, один хорошо выбранный ролик может дать 10–20 добротных слов без необходимости разбирать каждую строку.
Какой должна быть хорошая карточка из строки субтитров
Карточка из голого слова и его перевода обесценивает весь смысл сбора. Контекст и есть причина, по которой вы вытащили предложение, поэтому карточка должна его сохранить.
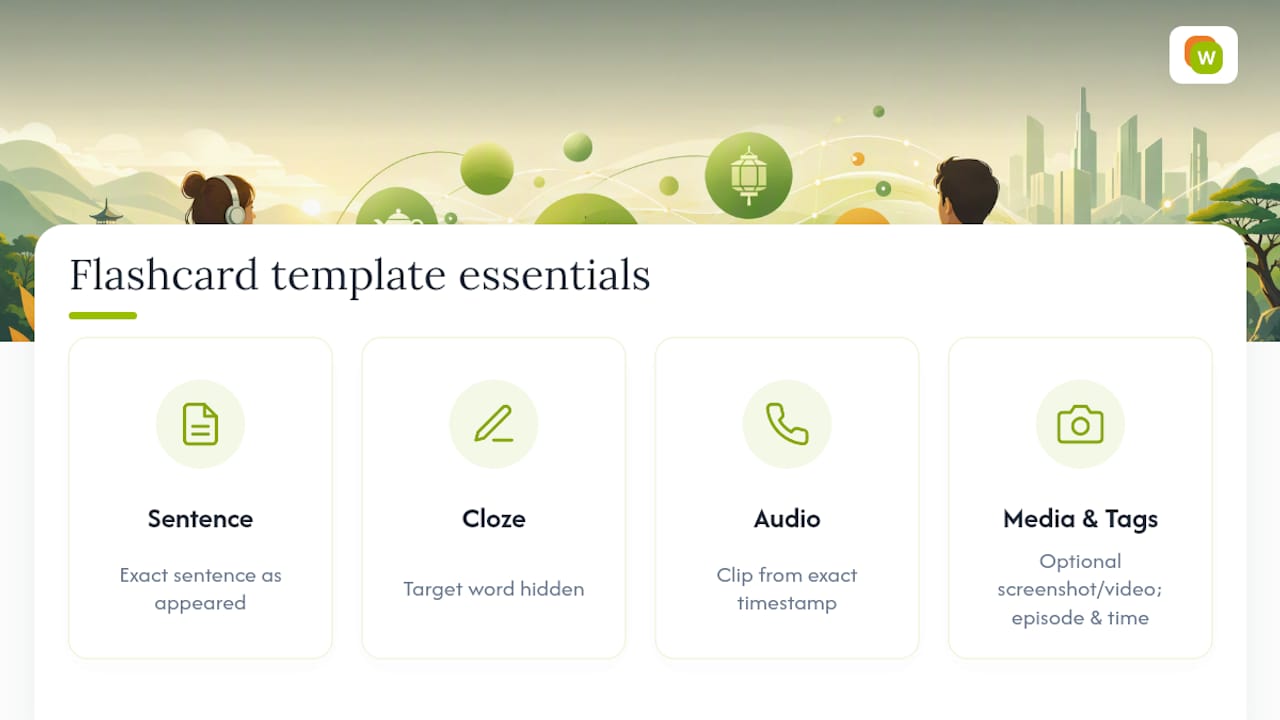
Добротный шаблон карточки из субтитров включает: предложение целиком в том виде, как оно встретилось; целевое слово в виде пропуска, а не отдельно; аудиофрагмент с этого тайм-кода; и, где это удобно, снимок экрана или короткий отрывок видео со сценой. Опытные ученики идут дальше и помечают карточки номером серии, тайм-кодом и коротким описанием сцены, чтобы восстановить исходный контекст и пересмотреть фрагмент, если на повторении слово начинает ускользать.
Звук важнее, чем кажется поначалу. Написанное предложение учит значению и грамматике, но услышанная реплика — с её ритмом, ударением и произношением — учит тому, как предложение звучит в живой речи. Это другой навык, отличный от понимания текста, и карточки без звука его просто не развивают.
Отрывки видео — самая трудоёмкая версия этого шаблона, и нужны они не для каждой карточки. Оставьте их для предложений с важным визуальным контекстом: идиом, связанных с жестом или выражением лица, или диалогов, где интонация меняет смысл. Для обычной лексики предложения, звука и пропуска хватает почти всегда.
Разбивка текста субтитров на чистые предложения перед сборкой карточек также предотвращает частую ошибку — карточки из неловких обрывков посреди фразы. Если рассматривать каждую строку субтитров как пропорциональный отрезок времени всей сцены, легче отбирать строки с естественной интонацией — такие, что действительно звучат как речь носителя, а не как обрубок, разрезанный правилом тайминга.
Ручная цепочка инструментов или единое приложение: что выбрать
Пакетная обработка, исследовательская работа и точная перенастройка тайминга действительно требуют ручного конвейера. Если вы разбираете целый сезон разом или правите системные ошибки тайминга по всему файлу, специализированные инструменты извлечения и чистки дают больше контроля.
Ежедневный сбор — другая задача. Если у вас есть пять-десять минут и вы хотите взять лексику из того, что смотрите сегодня, единый инструмент, который переводит, сохраняет и создаёт карточку одним движением, выигрывает у жонглирования отдельными приложениями. Решайте по объёму и частоте: редкие большие партии — за ручные инструменты, ежедневные небольшие занятия — за единое приложение.
— Команда WordByWord
Начните работать с субтитрами без лишних шагов
Работу с субтитрами упрощают инструменты, которые объединяют извлечение, чистку и сборку карточек в одно действие в браузере. Вместо того чтобы вытаскивать файл субтитров, чистить его и выгружать в отдельное приложение для повторений, некоторые инструменты позволяют сохранять предложения с контекстом прямо из субтитров к видео и ставить их в расписание повторений.
Расширение для браузера работает с субтитрами YouTube, сайтами и PDF более чем на 50 языках, поэтому привычка, выработанная на одном видео, переносится на всё остальное, что вы читаете и смотрите. Некоторые инструменты ещё до просмотра подсвечивают, какие слова уже известны, и показывают, соответствует ли контент вашему уровню понимания.
У некоторых платформ для изучения языков есть бесплатные тарифы с ограничениями по объёму, которые позволяют проверить порядок работы с субтитрами, прежде чем рассматривать платные планы с расширенными возможностями. Установите расширение для изучения языков и разберите следующее видео простым способом.
Источники
- Subtitle Edit Rate (SubER) — ACL Anthology (2022)
- Geeklink
- subtools: Subtitle text analysis vignette — CRAN
Частые вопросы
Что значит «собирать предложения»?
Это значит вынимать из контента для носителей целые предложения, обычно с ровно одним незнакомым словом, и сохранять их как карточки вместо того, чтобы учить отдельные списки слов. Так сохраняются контекст и личная значимость, а оба они укрепляют запоминание по сравнению с обычными списками.
Как собирать предложения с помощью браузерного инструмента вроде Yomitan?
Браузерные инструменты перевода позволяют нажать на незнакомое слово на веб-странице, в субтитрах или в документе и сразу получить значение, которое вы сохраняете вместе с предложением для повторения. WordByWord работает по тому же принципу в субтитрах YouTube, PDF и на сайтах, сочетая перевод с автоматическим созданием карточек и интервальным графиком.
Чем внешние субтитры отличаются от вшитых?
Внешние субтитры — это отдельные текстовые дорожки, например файлы SRT или VTT, которые можно копировать и править напрямую. Вшитые впечатаны в само изображение, и чтобы получить редактируемый текст, их нужно распознать.
Сколько слов брать с одного видео?
Большинство получает стабильный результат при умеренном числе новых слов за сеанс: большие порции обычно переполняют расписание повторений за неделю.
Почему ошибки тайминга субтитров важны для сбора?
Плохо разделённые или сдвинутые по времени субтитры часто дают неполные или искажённые предложения, по которым труднее учиться. Метрики вроде SubER созданы именно потому, что тайминг и деление на строки влияют на пригодность не меньше, чем точность текста.