Die Wortschatzabdeckung ist der Anteil der laufenden Wörter eines Textes, die ein Leser bereits kennt, und einer der stärksten Prädiktoren dafür, ob er das Gelesene versteht. Jahrzehnte der Forschung, beginnend mit der Arbeit von Laufer und Ravenhorst-Kalovski zur lexikalischen Schwelle, laufen auf zwei praktische Richtwerte hinaus: 95 % Abdeckung als Mindestmaß und 98 % als das Niveau, bei dem sich ohne Hilfe bequem lesen lässt. Umgerechnet entspricht das grob 4.000 bis 5.000 Wortfamilien für die untere und rund 8.000 für die obere Marke.
Das Wichtigste in Kürze:
- Die ersten 1.000 häufigsten Wortfamilien decken rund 72 % der meisten Texte ab und erleichtern das Grundverständnis.
- Für 95 % Abdeckung braucht es etwa 4.000 bis 5.000 Wortfamilien, für 98 % rund 8.000, und davon hängt ab, wie flüssig sich lesen lässt.
- Hör- und audiovisuelles Verstehen vertragen meist eine niedrigere Abdeckung als das Lesen, weil Kontext und Prosodie unbekannte Wörter ausgleichen.
- Abdeckung wird gemessen, indem Texte in Wörter zerlegt und mit Häufigkeitslisten abgeglichen werden, doch kurze Proben unter 200 Wörtern liefern unzuverlässige Werte.
- Unterricht und Bewertung sollten Abdeckungsziele differenzieren: 95 % für extensives Lesen und Lesevergnügen, 98 % für anspruchsvolle akademische und technische Texte.
Inhalt
- Was Wortschatzabdeckung in Texten ist
- Wie die Schwellenwerte zwischen Studien variieren
- Wie Abdeckung in der Praxis gemessen wird
- Was die Schwellen für Unterricht und Bewertung bedeuten
- Wo Abdeckungsmaße an ihre Grenzen stoßen
- Eine praktische Checkliste zum Messen und Handeln
- Quellen
- Häufige Fragen
Was Wortschatzabdeckung in Texten ist
Die Wortschatzabdeckung misst den Anteil der Wörter eines Textes, die ein Leser erkennt, ausgedrückt als Prozentsatz aller laufenden Wörter, nicht der verschiedenen Wörter. Forschende berechnen sie, indem sie einen Text in einzelne Wörter zerlegen und jedes mit einer nach Häufigkeit geordneten Wortliste oder mit dem Profil des bekannten Wortschatzes eines Lesers oder einer Lerngruppe abgleichen.
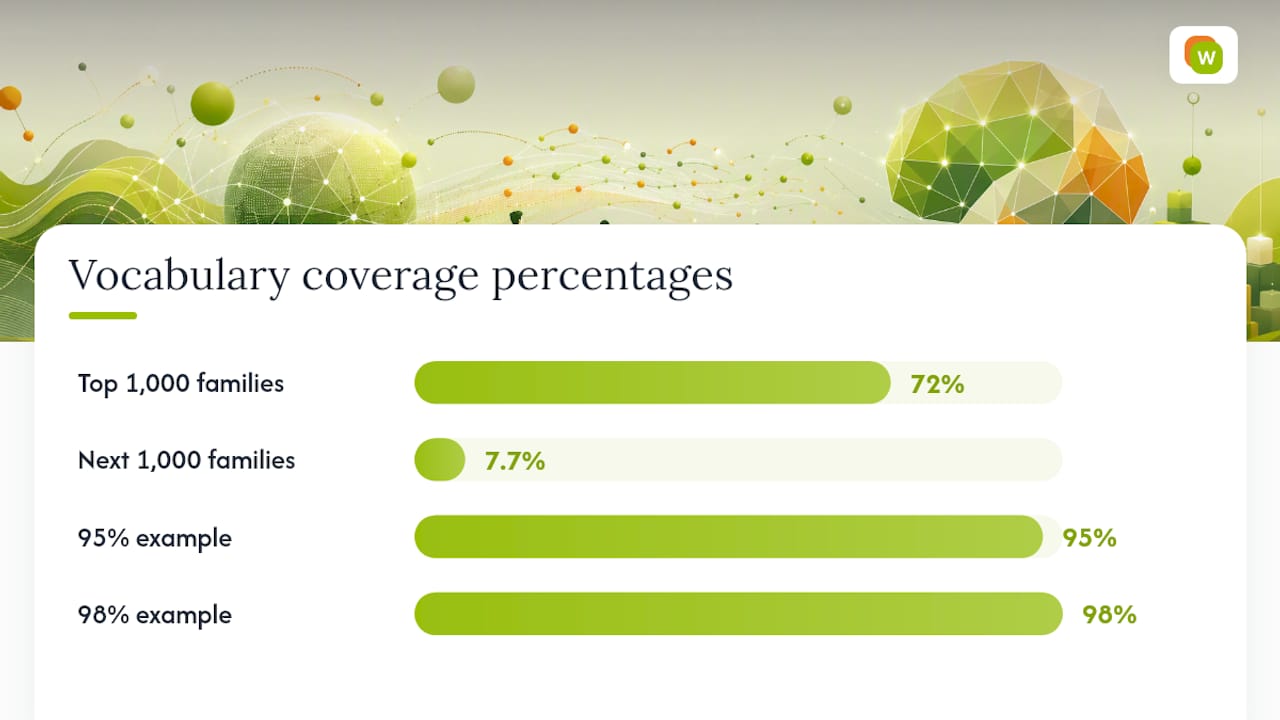
Die Rechnung dahinter ist trügerisch einfach, das Muster, das sie offenlegt, ist es nicht. Die Worthäufigkeit folgt in jeder Sprache einer Zipf-Verteilung: Eine kleine Zahl von Wörtern macht einen riesigen Anteil jedes Textes aus. Deshalb decken die ersten 1.000 häufigsten Wortfamilien etwa 72 % eines typischen Textes ab, während die nächsten 1.000 nur rund 7,7 Prozentpunkte hinzufügen. Der Zuwachs schrumpft schnell, je weiter man die Häufigkeitsliste hinabsteigt, und genau deshalb kostet es so viel mehr Wortfamilien, die letzten Prozentpunkte bis 98 % zu schließen als die ersten 70 %.
Ein kurzes Rechenbeispiel macht das greifbar:
- Ein Artikel mit 500 Wörtern, von denen ein Leser 475 kennt, liegt bei 95 % Abdeckung, das heißt etwa jedes zwanzigste Wort ist unbekannt.
- Derselbe Artikel bei 98 % Abdeckung enthält nur 10 unbekannte Wörter, etwa eines von fünfzig.
- Diese fünf Wörter Unterschied zwischen 95 und 98 % sind die Stelle, an der Lesen oft von „machbar, aber anstrengend“ zu „flüssig“ wird.
Wie die Schwellenwerte zwischen Studien variieren
Die Werte 95 % und 98 % sind kein Ergebnis einer einzelnen Studie, sondern ein Muster, das sich über einen ganzen Forschungsbestand hinweg zeigt, mit echter Streuung darunter. Die grundlegende Studie von Laufer und Ravenhorst-Kalovski setzte die optimale Schwelle bei 98 % Abdeckung an, entsprechend rund 8.000 Wortfamilien einschließlich Eigennamen, und die Mindestschwelle bei 95 %, näher an 4.000 bis 5.000 Familien.
Andere Arbeiten verkomplizieren das Bild auf nützliche Weise. Die Studie zum Anteil bekannter Wörter in einem Text und zum Leseverständnis findet eine im Großen und Ganzen positive, abgestufte Beziehung zwischen dem Anteil bekannter Wörter und den Verständniswerten statt einer scharfen Kante an einer der Schwellen und schlägt 98 % als sinnvolles Ziel speziell für akademische Texte vor. Diese Abstufung ist wichtig: Abdeckung wirkt eher wie ein Regler als wie ein Schalter, und das Verständnis steigt mit der Abdeckung stetig, statt bei einer Zahl plötzlich umzuschlagen.
Der Wortfamilienbereich hinter den Schwellen: 95 % Abdeckung entsprechen bei vielen allgemeinen Texten etwa 4.000 bis 5.000 Wortfamilien, während 98 % in der Regel rund 8.000 erfordern, so die Forschung zur lexikalischen Schwelle.
Auch die Modalität spielt eine Rolle. Hör- und audiovisuelles Verstehen vertragen meist eine niedrigere Abdeckung als das Lesen, weil Prosodie, Bild und Kontext einen Teil der Last tragen, während dichte akademische Prosa in der Regel eine Abdeckung am oberen Ende des Bereichs verlangt, nur um lesbar zu bleiben.
Wie Abdeckung in der Praxis gemessen wird
Das lexikalische Profiling ist das Standardverfahren und läuft in drei Schritten. Zuerst wird ein Text in einzelne Wörter zerlegt. Dann wird jedes Wort einer Wortfamilie auf einer nach Häufigkeit geordneten Liste zugeordnet, denn wer „run“ kennt, bekommt Teilpunkte für „running“, „runner“ und „ran“. Schließlich zählt ein Skript aus, welchen Prozentsatz aller laufenden Wörter der bekannte Wortschatz des Lesers abdeckt.
Dafür gebaute Werkzeuge sind unter anderem:
- Vocabulary Profile und das English Vocabulary Profile, die Wörter Häufigkeitsbändern und GER-Niveaus zuordnen, um sie mit dem bekannten Wortschatz eines Lernenden abzugleichen.
- Häufigkeitslisten aus großen Korpora wie dem British National Corpus oder COCA, die überhaupt erst festlegen, was in einer Sprache „häufig“ bedeutet.
- Neuere Ansätze mit Unterstützung von Sprachmodellen, die die Wortkenntnis im Kontext bewerten statt über den Abgleich mit einer statischen Liste, was bei Polysemie hilft, da ein Wort wie „light“ je nach umgebendem Satz etwas anderes bedeutet.
Tipp: Abdeckungswerte sind nur so verlässlich wie die Probe, auf der sie berechnet wurden. Geben Sie keine Abdeckung für Texte unter 200 laufenden Wörtern an, denn kurze Proben schwanken wegen einer Handvoll seltener Wörter stark; ist ein kurzer Text unvermeidlich, mitteln Sie über mehrere Proben, statt einem einzelnen Wert zu trauen.
Mehrwortausdrücke sind die andere stille Falle. Ein regelbasiertes Werkzeug, das „kick the bucket“ als drei einzeln bekannte Wörter wertet, überschätzt das tatsächliche Verständnis dieses Satzes.
Was die Schwellen für Unterricht und Bewertung bedeuten
Abdeckungsziele sollten sich danach richten, was eine Unterrichtsstunde oder eine Prüfung tatsächlich erreichen will, und 95 % und 98 % als austauschbare Standardwerte zu behandeln ist ein häufiger Fehler.
- Nutzen Sie 95 % für verständlichen Input und extensives Lesen. Wenn es um Menge, Vergnügen und beiläufigen Wortschatzerwerb geht statt um vollständiges Verständnis, hält eine Untergrenze von 95 % Texte fordernd, ohne den Leser zu überfordern. Das ist das Terrain des extensiven Lesens als Unterrichtsform.
- Reservieren Sie 98 % für eigenständiges Lesen mit hohem Einsatz. Wissenschaftliche Artikel, Prüfungstexte und technisches Material brauchen in der Regel die höhere Marke, weil keine Lehrkraft und kein Kontext Verständnislücken füllt.
- Wählen Sie Texte gezielt aus. Vereinfachte Lektüren erreichen 98 % Abdeckung schon mit 3.000 Wortfamilien, während unbearbeitete Romane oder Zeitungstexte oft 8.000 bis 14.000 Familien brauchen, um dieselbe Obergrenze zu erreichen; die Textwahl leistet also mehr, als die meisten annehmen.
- Priorisieren Sie Wortschatz der zweiten Stufe im Unterricht. Akademische, fächerübergreifende Wörter, die in vielen Fächern vorkommen, bringen den größten Abdeckungsgewinn pro Unterrichtsstunde, mehr als seltene Fachbegriffe oder ohnehin bekannte Wörter der ersten Stufe. Mehr dazu im Beitrag über Prioritäten bei Verständnis und Wortschatz.
- Kombinieren Sie Abdeckung mit Prüfungen des Erkennens im Kontext. Ein reiner Prozentwert sagt, was ein Leser wahrscheinlich weiß; eine Aufgabe nach dem Vorbild von ROAR-Written Vocabulary zeigt, ob er die Bedeutung im Kontext tatsächlich abrufen kann, und das ist das eigentliche Ziel.
Wo Abdeckungsmaße an ihre Grenzen stoßen
Abdeckung sagt Verständnis voraus, garantiert es aber nicht. Ein paar Vorbehalte halten die Zahlen ehrlich:
- Auch bei hoher Abdeckung kann ein Leser verwirrt bleiben, wenn die unbekannten 2 % aus dichten, konzeptgeladenen Begriffen statt aus Füllwörtern bestehen.
- Kurze Texte, starke Polysemie und Mehrwortausdrücke verringern die Verlässlichkeit eines einzelnen Abdeckungswerts, ein Punkt, den die Forschung zu den Grenzen des lexikalischen Profilings bestätigt.
- Diversitätsindizes wie das Type-Token-Verhältnis oder MATTR sind nützliche Nebenmaße für Textkomplexität, aber sie sind bei kurzen Proben instabil und ersetzen die Abdeckung nicht, wenn es um Verständnis geht.
- Ein Großteil der klassischen Schwellenliteratur stützt sich auf eine überschaubare Zahl von Studien, sodass 95 % und 98 % als universelle Gesetze statt als nützliche Näherungen zu behandeln mehr behauptet, als die Belege hergeben.
Transparente Berichterstattung, also Textsorte, Probenlänge und verwendetes Referenzkorpus, ist wichtiger, als die meisten Arbeiten zugeben.
Eine praktische Checkliste zum Messen und Handeln
Forschende und Lehrkräfte profitieren von einer wiederholbaren Abfolge mehr als von einem flüchtigen Blick auf einen Prozentwert.
- Wählen Sie eine repräsentative Textprobe, idealerweise mit 200 laufenden Wörtern oder mehr, passend zum Genre, um das es Ihnen wirklich geht.
- Wählen Sie eine Häufigkeitsliste oder ein Profiling-Werkzeug und nennen Sie es, denn Abdeckungsschätzungen verschieben sich je nachdem, ob Sie eine BNC-basierte Liste oder ein anderes Korpus verwenden.
- Führen Sie die Zerlegung und die Abdeckungsberechnung durch und erfassen Sie dabei Wortfamilien statt roher Wortformen.
- Berichten Sie die Methode zusammen mit der Zahl. Textsorte, Probenlänge und Korpusquelle gehören in die Darstellung, nicht nur der Endprozentsatz.
- Ergänzen Sie den Abdeckungswert um eine Verständnisprüfung, sei es ein Lückentest, eine Nacherzählung oder ein Instrument zum Erkennen im Kontext.
- Handeln Sie nach der Lücke. Liegt die Abdeckung unter 95 %, vermitteln Sie Schlüsselwortschatz vorab oder tauschen Sie die Texte; liegt sie über 98 %, kommt eigenständiges Lesen in Frage.
Tipp: Wenn Sie Ihr eigenes Leseniveau verfolgen und keine formale Studie durchführen, kann ein Werkzeug wie die Browser-Erweiterung von WordByWord das Verständnisniveau einer Seite anzeigen, bevor Sie sich ans Lesen machen, dieselbe Logik wie eine Abdeckungsberechnung, nur in Echtzeit statt im Nachhinein. Für den Unterricht führt der Leitfaden von WordByWord zum Verfolgen von Vokabeln beim Lesen Schritt für Schritt durch ein ähnliches Verfahren.
Einem Lernenden vor Beginn eines Textes sein Verständnisniveau zu zeigen leistet dasselbe wie eine Berechnung der lexikalischen Abdeckung, nur schneller und im Kontext. Der Spotlight-Modus hebt unbekannte Wörter direkt auf der Seite hervor und macht die Lücke sichtbar zwischen dem, was ein Leser weiß, und dem, was ein Text verlangt. Allerdings sind die In-App-Daten einer Erweiterung darüber, was ein einzelner Lernender kennt, ein nützliches Signal für tägliche Lernentscheidungen, kein Ersatz für kontrollierte Forschung zu Schwellenwerten. Beides sollte sich gegenseitig informieren, nicht ersetzen.
— Das WordByWord-Team
Quellen
- Lexical threshold revisited: Lexical text coverage, learners’ vocabulary size and reading comprehension
- Research Investigating Lexical Coverage and Lexical Profiling: What We Know, What We Don’t Know, and What Needs to be Examined
- ROAR-Written Vocabulary (ROAR Comprehension Suite) — instrument description
Häufige Fragen
Wie findet man Vokabeln in einem Text?
Lassen Sie den Text durch ein Werkzeug für lexikalisches Profiling wie Vocabulary Profile laufen, das jedes Wort erfasst und die außerhalb der häufigen Bänder markiert, oder gleichen Sie ihn von Hand mit einer Häufigkeitsliste ab, um zu sehen, welche Wörter außerhalb des bekannten Wortschatzes des Lesers liegen.
Was sind die wichtigsten Arten von Textstruktur?
In der Leseforschung werden üblicherweise Beschreibung, Abfolge, Ursache und Wirkung, Vergleich und Gegenüberstellung sowie Problem und Lösung unterschieden; manche Modelle ergänzen die Erzählstruktur als eigene sechste oder siebte Kategorie, wobei die Definitionen je nach Quelle variieren.
Können Sie Beispiele für Wörter nach Häufigkeitsstufe nennen?
Hochfrequente Beispiele sind „the“, „make“ und „get“; mittelfrequente akademische Beispiele sind „significant“, „factor“, „analyze“ und „context“; niederfrequente oder fachliche Beispiele sind „morpheme“, „corpus“, „lexeme“ und „polysemy“, jeweils aus einem anderen Band einer nach Häufigkeit geordneten Liste.
Welche Arten von Wortschatz verfolgen Lehrkräfte?
Die Wortschatzforschung unterteilt Wörter in der Regel in Hör-, Sprech-, Lese- und Schreibwortschatz, manchmal mit einer fünften Kategorie für den Sichtwortschatz, was widerspiegelt, dass der rezeptive Wortschatz eines Lernenden (verstandene Wörter) meist größer ist als der produktive (verwendete Wörter).
Sind 95 % oder 98 % das bessere Ziel für Sprachlernende?
Das hängt vom Ziel ab: 95 % Abdeckung eignen sich gut für extensives Lesen und verständlichen Input, während 98 % zum eigenständigen Lesen anspruchsvoller akademischer oder technischer Texte passen, so die Ergebnisse von Laufer und Ravenhorst-Kalovski.