Subtitle Mining bedeutet, Sätze direkt aus der Untertitelspur eines Videos zu ziehen und diejenigen mit genau einem unbekannten Wort in Karteikarten für Spaced Repetition zu verwandeln. Der schnellste Einstieg: Öffnen Sie die Untertiteldatei oder -spur zu etwas, das Sie ohnehin gerade sehen, suchen Sie eine Zeile, in der Sie alles bis auf ein Wort oder eine Wendung verstehen, und speichern Sie diesen ganzen Satz, nicht nur das Wort, in Ihrem Wiederholungssystem.
Das Wichtigste in Kürze:
- Qualität und saubere Segmentierung der Untertitel entscheiden direkt darüber, ob gesammelte Sätze zum Lernen und Behalten taugen.
- Das Herausfiltern häufiger und bereits bekannter Wörter entlastet die Wiederholung und lenkt den Blick auf wirklich neuen Wortschatz.
- Integrierte Werkzeuge oder Browser-Erweiterungen fassen Extraktion, Bereinigung und Kartenerstellung in einem Schritt zusammen.
- Inhalte mit einem Verständnisniveau von etwa 80 bis 90 Prozent bieten die beste Balance zwischen Herausforderung und Lernbarkeit.
- Audioclips und visueller Kontext auf Karteikarten unterstützen Aussprache und Verständnis und machen die Wiederholung wirksamer.
Inhalt
- Was Subtitle Mining ist und warum die 1T-Regel zählt
- Welche Untertitelformate und Werkzeuge Sie wirklich brauchen
- Wie Sie Untertitel vor dem Mining extrahieren und bereinigen
- Der Ablauf in fünf Schritten
- Wie Timing- und Segmentierungsfehler das Ergebnis verderben
- Wie WordByWord das Subtitle Mining vereinfacht
- Lassen sich bekannte Wörter automatisch herausfiltern?
- Jenseits von Anki: andere Wege, die gesammelten Karten zu wiederholen
- Untertitel mit mehreren Sprachen oder Dialekten
- Wie Sie die richtigen Inhalte auswählen
- Was eine gute Karteikarte aus einer Untertitelzeile ausmacht
- Manuelle Werkzeugkette oder integrierte App: was sollten Sie nutzen?
- Starten Sie mit Untertiteln ohne die zusätzlichen Schritte
- Quellen
- Häufige Fragen
Was Subtitle Mining ist und warum die 1T-Regel zählt
Subtitle Mining ist die gezielte Alternative zum passiven Mitlesen von Untertiteln. Mitlesen bringt Sie in Kontakt mit der Sprache, zwingt aber nicht zum Behalten. Mining tut das, weil Sie bestimmte Sätze herausziehen und sie später bewusst wiederholen.
Die Technik beruht auf einer Faustregel namens 1T-Regel, kurz für „one target“, ein Ziel. Sie wählen Sätze mit genau einem Wort oder einer Wendung, die Sie nicht kennen, während alles andere verständlich bleibt. So bleibt die kognitive Last niedrig genug, dass Ihr Gehirn das neue Element an den Kontext binden kann, statt gleichzeitig in unbekannter Grammatik und Vokabeln zu versinken. Fortgeschrittene Lernende verlassen sich seit Jahren auf diese Regel, weil sie das Erstellen von Karteikarten beschleunigt und das Behalten zuverlässiger macht: Persönliches, kontextreiches Material schlägt feste Wortlisten für die meisten Lernenden.
Drei Dinge machen gesammelte Sätze haltbarer als Wörterbucheinträge:
- Kontext: Das Wort kommt mit Grammatik, Tonfall und Situation, statt allein zu schweben.
- Persönlicher Bezug: Sie haben den Satz gewählt, weil Sie sich ohnehin mit dem Inhalt beschäftigt haben.
- Spaced Repetition: Wiederholung in wachsenden Abständen verankert den Satz im Langzeitgedächtnis statt im kurzfristigen Wiedererkennen.
Nichts davon funktioniert, wenn der Satz selbst verstümmelt ist, und hier wird die Untertitelqualität zu einer echten Variablen, nicht zu einer Fußnote.
Welche Untertitelformate und Werkzeuge Sie wirklich brauchen
Ihnen begegnen zwei Arten von Untertiteln, und sie verlangen völlig unterschiedliche Behandlung.
Softsubs sind separate Textdateien oder eingebettete Textspuren. SRT ist das älteste und einfachste Format, VTT ist bei Webvideos und YouTube verbreitet, und ASS unterstützt Formatierung und Positionierung, wie sie oft bei fanübersetzten Animes vorkommt. Alle drei sind im Kern reiner Text, das heißt, Sie können sie in jedem Texteditor öffnen, durchsuchen und Zeilen direkt in eine Karteikarte kopieren.
Hardsubs sind fest ins Videobild eingebrannt. Es gibt keine Textebene zum Kopieren. Wenn Sie den Untertiteltext nicht markieren oder durchsuchen können, ist er eingebrannt, und Sie brauchen eine Texterkennung, um ihn bearbeitbar zu machen.
Zum Navigieren brauchen Sie einen Videoplayer, der Untertitel-Zeitstempel anzeigt, damit Sie zu einer Zeile zurückspringen, die Aussprache prüfen oder einen Clip herausziehen können. Das ist alles. Eine spezielle App ist für diesen Schritt nicht nötig.
Formatierungseigenheiten, mit denen Sie in beiden Formaten rechnen sollten:
- Geräuschbeschreibungen in Klammern wie „[Tür knarrt]“, die keine Dialoge sind.
- Sprecherkennzeichnungen („JOHN:“) am Zeilenanfang.
- Formatierungstags (Kursiv, Farbcodes), die aus der Originaldatei übrig sind.
- Sätze, die über zwei oder drei Untertitelblöcke verteilt sind und zusammengeführt werden müssen, bevor sie sich natürlich lesen.
Wie Sie Untertitel vor dem Mining extrahieren und bereinigen
Prüfen Sie zuerst, ob Ihre Quelle eine echte Untertitelspur hat. Die meisten Streaming-Plattformen und heruntergeladenen Videodateien zeigen eine an, wenn sie existiert. Wenn Sie Untertitel ein- und ausschalten können und der Text unabhängig von der Videokompression scharf bleibt, handelt es sich um Softsubs. Verschwinden die Untertitel vollständig, wenn Sie die Anzeige abschalten, oder hat die Datei gar keine separate Spur, haben Sie Hardsubs vor sich.
Für eingebrannten Text sieht der übliche Ablauf mit Texterkennung so aus:
- Einzelbilder oder Keyframes des Videos bei jedem Untertitelwechsel erfassen.
- Die Bilder durch eine Texterkennung laufen lassen, um den Text zu gewinnen.
- Den erkannten Text in das Format SRT oder VTT umwandeln.
- Die Zeitstempel am Originalvideo ausrichten, damit die Zeilen synchron laufen.
Moderne Texterkennung bewältigt das bei klarem Material recht gut; manche Engines melden bei sauber erfassten Bildern eine Genauigkeit von nahezu 99 %, doch unruhige Hintergründe, stilisierte Schriften oder niedrige Auflösung drücken diesen Wert schnell nach unten.
Bei Softsubs heißt Bereinigen: Klammerbeschreibungen entfernen, Sprecherkennzeichnungen löschen, übrig gebliebene Formatierungstags streichen und Zeilen so zusammenführen oder trennen, dass jede als vollständiger Satz gelesen werden kann und nicht als Fragment.
Tipp: Prüfen Sie die Texterkennung stichprobenartig, indem Sie fünf Sekunden Ton mit dem umgewandelten Text vergleichen, bevor Sie einer ganzen Datei vertrauen. Eine einzelne falsche Zeile am Anfang deutet meist auf ein Schrift- oder Kontrastproblem hin, das den Rest des Stapels betrifft.
Der Ablauf in fünf Schritten
Das ist die Reihenfolge, die ein Video in Lernmaterial verwandelt, ohne den ganzen Abend zu verschlingen.
- Untertitel extrahieren oder öffnen. Laden Sie die Softsub-Spur, falls vorhanden, oder lassen Sie Hardsubs zuerst durch die Texterkennung laufen. So oder so: Bringen Sie den Text in ein bearbeitbares Format, bevor Sie das Video wieder anfassen.
- Zeilen bereinigen und vereinheitlichen. Entfernen Sie Geräuschklammern, Sprecherkennzeichnungen und lose Formatierung, damit jede Zeile als natürlicher Satz und nicht als Untertitelfragment gelesen werden kann.
- Sätze nach der 1T-Regel auswählen. Suchen Sie Zeilen mit genau einem unbekannten Wort oder einer Wendung und notieren Sie den Zeitstempel, damit Sie später Ton oder Screenshot herausziehen können.
- Die Karteikarte bauen. Nehmen Sie den ganzen Satz auf, das Zielwort als Lückentext markiert, einen Audioclip oder Screenshot von diesem Zeitstempel und ein Tag mit dem Quellvideo.
- Täglich wiederholen und das Behalten verfolgen. Spaced Repetition funktioniert nur, wenn Sie die Wiederholungen tatsächlich machen; behandeln Sie die fünf bis zehn Minuten täglicher Wiederholung als nicht verhandelbar.
Ein paar Dinge machen diesen Kreislauf tragfähig statt erschöpfend:
- Begrenzen Sie jede Sitzung auf 8 bis 12 neue Wörter. Mehr überlastet Ihre Wiederholungswarteschlange innerhalb einer Woche.
- Sammeln Sie nicht jedes unbekannte Wort einer Szene. Wählen Sie die, die nützlich wirken oder wiederkehren.
- Behalten Sie den Zeitstempel, auch wenn Sie ihn nicht sofort nutzen. Sie brauchen ihn, wenn eine Karte bei der Wiederholung durchfällt.
Eine speziell auf YouTube zugeschnittene Version desselben Kreislaufs beschreibt der Beitrag zur Lernsitzung in 5 bis 10 Minuten: Aus einem einzigen Video lässt sich eine solide Portion Wortschatz ziehen, ohne die Sehzeit zu sprengen.
Wie Timing- und Segmentierungsfehler das Ergebnis verderben
Schlechte Segmentierung ruiniert Sätze, bevor Sie überhaupt beim Wortschatz ankommen. Wenn eine Untertitelzeile mitten im Teilsatz abbricht oder ein Satz mit zwei Sekunden Pause auf zwei Blöcke verteilt ist, sammeln Sie einen halben Gedanken statt eines brauchbaren Beispiels.
Forschende haben die Metrik SubER genau deshalb entwickelt, weil reine Textgenauigkeit dieses Problem nicht erfasste. SubER verbindet Textkorrekturen mit Segmentierungs- und Timingfehlern, und die Bewertung durch Menschen zeigt, dass sie den tatsächlichen Nachbearbeitungsaufwand weit besser abbildet als die Wortfehlerrate allein. Verwandte Arbeiten bestätigen, dass timingbewusste Metriken stärker mit dem Aufwand zum Korrigieren eines Untertitels korrelieren als Metriken, die nur den Text mit einer Referenz vergleichen. Für Lernende heißt das ganz direkt: Aus einer falsch getimten oder schlecht segmentierten Zeile lernt es sich schwerer, nicht nur bearbeiten lässt sie sich schwerer.
Achten Sie beim Abspielen auf diese Anzeichen:
- Ein Satz endet abrupt und geht im nächsten Untertitelblock mit einer seltsamen Pause dazwischen weiter.
- Untertitel erscheinen deutlich vor oder nach dem passenden Ton.
- Automatisch erzeugte Untertitel, deren Wortlaut nicht zu dem passt, was tatsächlich gesagt wird.
Kleine Zeitversätze lohnt es sich zu beheben, indem Sie den Zeitstempel verschieben. Geteilte Sätze lohnt es sich zu einer Karte zusammenzuführen. Ist eine Zeile aber bis zur Unkenntlichkeit durcheinander, besonders bei automatischen Untertiteln, verwerfen Sie sie und gehen Sie zum nächsten Satz, statt Schrott zu sammeln.
Wie WordByWord das Subtitle Mining vereinfacht
Manuelles Mining funktioniert, stapelt aber mehrere getrennte Schritte: Extraktion, Bereinigung, Satzauswahl, Kartenbau und Wiederholungsplanung, womöglich in verschiedenen Apps. WordByWord fasst das meiste davon zu einer Bewegung im Browser zusammen.
- Nachschlagen auf der Seite: Klicken Sie ein unbekanntes Wort direkt in einem YouTube-Untertitel, auf einer Website oder in einem PDF an und erhalten Sie sofort eine Übersetzung in über 50 Sprachen.
- In Sammlung speichern: Satz und Wort werden automatisch zusammen gespeichert, sodass Sie keinen Text von Hand aus einer Untertiteldatei kopieren.
- Karteikarten erzeugen: Gespeichertes wird zu Karteikarten mit Sprachausgabe, bereit für Spaced Repetition ohne separaten Exportschritt.
- Spotlight-Modus: hebt Wörter auf der Seite danach hervor, wie gut Sie sie bereits kennen, sodass Sie das eine unbekannte Wort in einem vollen Satz nicht suchen müssen.
- Verständnisanzeige: zeigt, welchen Prozentsatz des Wortschatzes eines Videos Sie bereits kennen, bevor Sie Zeit investieren.
Der kostenlose Tarif lässt Sie diesen Ablauf mit Nutzungslimits ausprobieren, und Premium hebt sie für alle auf, die täglich in mehreren Sprachen mit Untertiteln arbeiten.
Lassen sich bekannte Wörter automatisch herausfiltern?
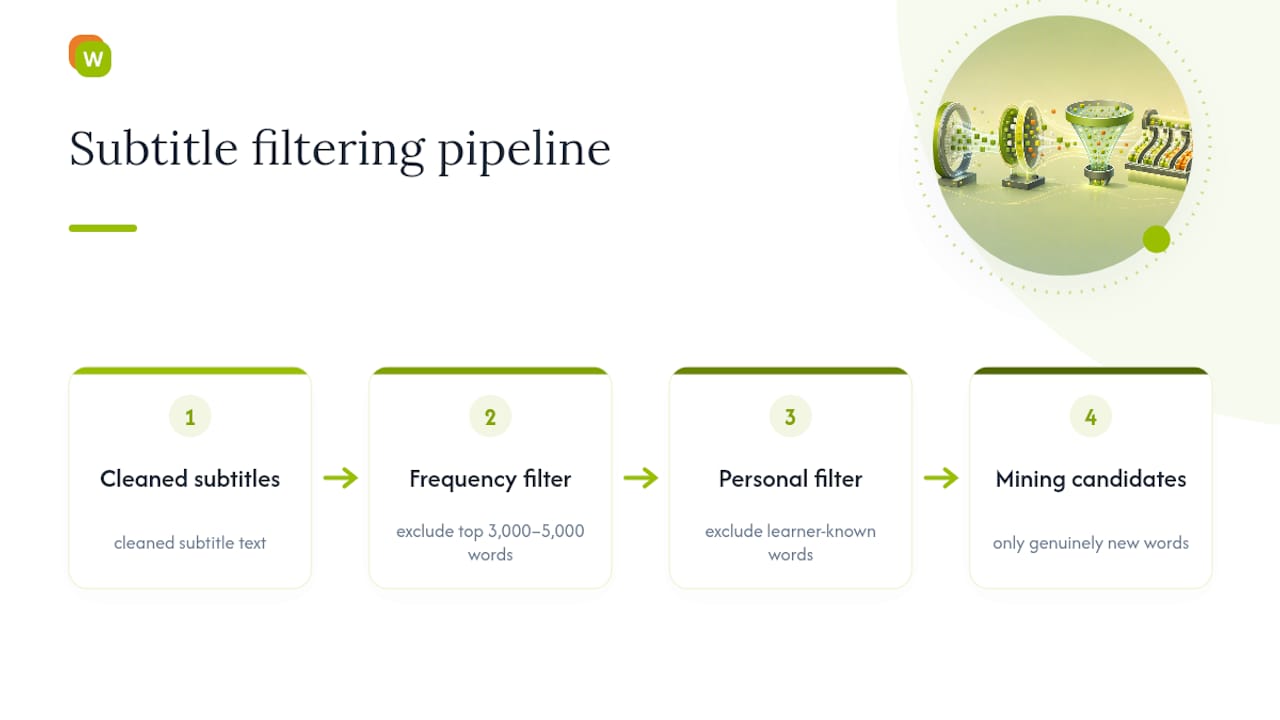
Jede Untertitelzeile von Hand nach unbekannten Vokabeln zu durchsuchen wird spätestens bei der dritten Folge des Tages mühsam. Häufigkeitsbasiertes Filtern löst das: Der Untertiteltext wird mit einer Häufigkeitsliste der Zielsprache verglichen, der Art von Rangliste, die Linguisten aus großen Textkorpora erstellen, und nur Wörter außerhalb der häufigsten paar tausend werden markiert.
Die Logik ist einfach: Hochfrequente Wörter wie Funktionswörter, Grundverben und Alltagssubstantive tauchen ständig auf, und wer überhaupt muttersprachliche Inhalte schaut, kennt die meisten davon bereits. Sie herauszufiltern bedeutet, dass Ihre Aufmerksamkeit direkt auf die wirklich lohnenden Wörter geht, statt „und“, „weil“ oder „ging“ zum hundertsten Mal zu markieren.
Eine Grundversion dieses Filters lässt sich mit einer Tabelle leicht selbst bauen: bereinigte Untertiteldatei einfügen, mit einer Häufigkeitsliste abgleichen und nach Rang sortieren. Alles außerhalb Ihrer Komfortschwelle, etwa der 3.000 bis 5.000 häufigsten Wörter für Fortgeschrittene, wird zum Kandidaten. Alles innerhalb der Schwelle wird automatisch übersprungen.
Ausgefeiltere Abläufe fügen eine zweite Filterebene hinzu: Ihre eigene Liste bekannter Wörter, gezogen aus dem Wortschatz, den Sie bereits gespeichert oder als gemeistert markiert haben. Das ist wichtig, weil eine Häufigkeitsliste allgemein ist. Sie weiß nicht, dass Sie persönlich ein seltenes Wort vor drei Wochen aus einer anderen Serie gelernt haben. Der Abgleich mit Ihrer persönlichen Wortschatzhistorie statt nur mit einer allgemeinen Häufigkeitsliste ist es, was doppeltes Sammeln tatsächlich verhindert.
Hier hat ein integriertes Werkzeug einen echten Vorteil gegenüber einer Tabelle. Software, die Ihre Wortschatzhistorie bereits kennt, wie die Verständnisanzeige von WordByWord, kann nur die Wörter markieren, die wirklich neu für Sie sind, und nicht nur statistisch seltene, und streicht den manuellen Filterschritt ganz.
Jenseits von Anki: andere Wege, die gesammelten Karten zu wiederholen
Anki dominiert die Gespräche über Sentence Mining, ist aber nicht das einzige Spaced-Repetition-System, das sich lohnt, und für manche Lernende nicht die beste Wahl.
Mobile SRS-Apps, die fürs Telefon gebaut sind, senken die Hürde für die tägliche Wiederholung, denn eine Wiederholungsrunde in der Warteschlange erledigt man eher als einen Stapel am Schreibtisch zu öffnen. Apps mit integrierter Audiounterstützung sind für Karten aus Untertiteln besonders wichtig, denn eine Karte ohne ihren ursprünglichen Audioclip verliert einen Gutteil ihres Lernwerts. Wenn Ihre Quelle dialoglastig ist, bevorzugen Sie jedes SRS-Werkzeug, das Ton direkt auf der Karte anhängen und abspielen lässt, nicht nur Text und Bilder.
Manche Lernende trennen den Ablauf vollständig: Sätze an einem Ort sammeln und bereinigen, die fertigen Karten dann in die App exportieren, die sie täglich wirklich gern nutzen. CSV-Export und -Import sind hier die übliche Brücke. Gibt Ihr Werkzeug eine Tabelle mit Spalten für Satz, Zielwort und Audiodatei aus, nehmen die meisten SRS-Apps diese Struktur mit kleinen Anpassungen an.
Die größere Verschiebung ist jedoch, Sammeln und Wiederholen in dieselbe App zu verlegen, statt sie als zwei getrennte Werkzeuge zu behandeln. Die Karteikarten von WordByWord unterstützen Sprachausgabe und sieben Trainingsmodi, darunter Tippen, Hören und einen 60-Sekunden-Sprint, automatisch nach Spaced Repetition geplant, sodass ein Satz, den Sie beim Ansehen eines Videos speichern, direkt in Ihre bestehende Wiederholungswarteschlange rutscht, ohne separaten Exportschritt. So gebaute Sammlungen lassen sich außerdem aus CSV, Anki oder Quizlet importieren oder dorthin exportieren, wenn Sie Wortschatz zwischen Systemen verschieben möchten.
Welche App es am Ende auch wird, entscheidend sollte sein, ob Sie sie tatsächlich täglich öffnen. Ein perfekter SRS-Algorithmus ist wertlos, wenn die App so nervt, dass Sie die Wiederholung drei Tage in Folge auslassen.
Untertitel mit mehreren Sprachen oder Dialekten
Untertiteldateien mit gemischten Sprachen oder Dialektvarianten bringen mehr Abläufe durcheinander, als die meisten erwarten. Doppelte Untertitel, bei denen Zielsprache und Referenzsprache gleichzeitig angezeigt werden, sind auf Sprachlernplattformen verbreitet und wirklich nützlich, um die Bedeutung zu bestätigen, bevor Sie einen Satz auf eine Karte setzen.
Aber gemischte Dateien bergen ein bestimmtes Risiko: versehentlich die falsche Sprache zu sammeln. Wechselt eine Untertitelspur zwischen Zielsprache und englischen Erläuterungen oder zwischen einem Standarddialekt und einem regionalen, kennzeichnen Sie Ihre Karten sofort nach Quellsprache, nicht erst, nachdem Sie einen Rückstand von fünfzig Karten aufgebaut haben, den Sie nun sortieren müssen.
Dialektunterschiede zählen sogar innerhalb einer Sprache. Lateinamerikanische und europäische spanische Untertitel verwenden unterschiedliche Wörter für Alltagsgegenstände, unterschiedliche Verbformen für die zweite Person und manchmal einen ganz anderen Satzrhythmus. Wenn Sie aus Inhalten in einem Dialekt sammeln, aber für den Kontakt mit einem anderen lernen, vermerken Sie das auf der Karte. Sonst zweifeln Sie irgendwann bei der Wiederholung an einer „falschen“ Antwort, die in Wahrheit nur eine regionale Variante war.
Wer mehr als eine Sprache gleichzeitig lernt, hält jede Sitzung bei einer Sprache: So geraten Häufigkeitsfilter nicht durcheinander, und es bleibt klar, mit welcher Liste bekannter Wörter Sie abgleichen. Wenn Sie eine Serie mit gleichzeitig angezeigten doppelten Untertiteln durcharbeiten, sammeln Sie aus der Spur der Zielsprache und nutzen die Referenzspur nur zur Bestätigung der Bedeutung, nicht als Haupttext.
Regionalen Slang und Sprachwechsel innerhalb einer Dialogzeile, wie sie in mehrsprachigen Regionen oder Medien mit starkem Migrationsbezug üblich sind, lohnt es sich bewusst zu sammeln statt zu überspringen. Genau diesen Wortschatz markiert keine Häufigkeitsliste, Muttersprachler benutzen ihn aber ständig.
Wie Sie die richtigen Inhalte auswählen
Nicht jedes Video lohnt das Mining. Das beste Quellmaterial liegt nahe an Ihrem Verständnisniveau, idealerweise ein Video, in dem Sie ohne Untertitel bereits 80 bis 90 % des Gesagten verstehen, damit der unbekannte Wortschatz hervorsticht, statt Sie zusätzlich zu unbekannten Wörtern in unbekannter Grammatik zu ertränken.
Das Verständnisniveau zählt mehr als das Genre. Ein Kinderzeichentrickfilm in Ihrer Zielsprache kann eine bessere Quelle sein als ein Prestigedrama, wenn dessen Dialoge dicht und schnell sind. Das Verständnisniveau eines Videos zu prüfen, bevor Sie sich festlegen, statt es vom Vorschaubild zu erraten, bewahrt Sie davor, halb bearbeitete Folgen aufzugeben, weil sich der Inhalt als zu schwer erwies.
Der zweite Filter ist der thematische Bezug. Wortschatz aus Inhalten zu sammeln, die Sie wirklich interessieren, bedeutet, dass Sie sich tatsächlich erinnern, warum Sie ein Wort gespeichert haben, und das stärkt den persönlichen Bezug, der Sentence Mining überhaupt erst allgemeinen Wortlisten überlegen macht. Eine Kochsendung lehrt Wortschatz rund ums Essen, den Sie nutzen werden; eine True-Crime-Dokumentation lehrt juristischen Wortschatz, den Sie außerhalb dieses Genres womöglich nie wieder anfassen.
Praktische Kriterien, die Sie vor einer Sitzung anlegen sollten:
- Tonqualität: Genuschelte oder stark akzentuierte Dialoge erschweren Texterkennung und manuelle Abschrift gleichermaßen.
- Verfügbarkeit von Untertiteln: Vergewissern Sie sich, dass eine echte Untertitelspur existiert, besonders bei älteren oder Nischeninhalten.
- Folgenlänge: Kürzere Clips (10 bis 20 Minuten) lassen sich ohne Ermüdung vollständig bearbeiten, ein zweistündiger Film nicht.
- Serienformat: Episodische Serien lassen Sie Wortschatz über Folgen hinweg aufbauen und früher gesammelte Wörter in neuen Kontexten festigen.
Wenn Sie speziell aus YouTube extrahieren, kann ein einziges gut gewähltes Video 10 bis 20 solide Vokabeln liefern, ohne dass Sie jede Zeile bearbeiten müssen.
Was eine gute Karteikarte aus einer Untertitelzeile ausmacht
Eine Karteikarte aus einem nackten Wort und seiner Übersetzung verschenkt den ganzen Sinn des Minings. Der Kontext ist der Grund, warum Sie den Satz überhaupt herausgezogen haben, also muss die Karte ihn bewahren.
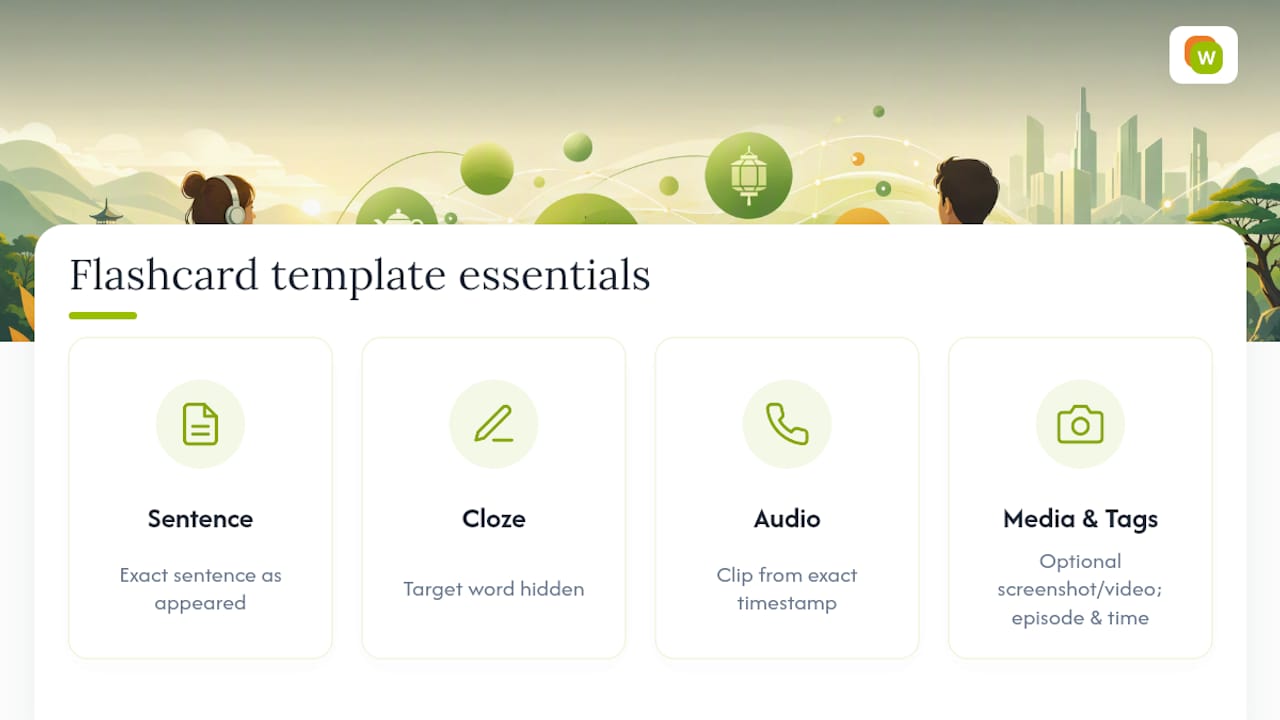
Eine solide Vorlage für Karten aus Untertiteln enthält: den vollständigen Satz genau so, wie er vorkam; das Zielwort als Lückentext statt isoliert; einen Audioclip von genau diesem Zeitstempel; und, wo es praktikabel ist, einen Screenshot oder kurzen Videoausschnitt der Szene. Fortgeschrittene gehen noch einen Schritt weiter und versehen Karten mit Metadaten wie Folgennummer, Zeitstempel und einer kurzen Szenenbeschreibung, womit sie den ursprünglichen Kontext zurückverfolgen und den Clip erneut ansehen können, wenn das Erinnern bei der Wiederholung nachlässt.
Ton ist wichtiger, als die meisten zunächst annehmen. Ein geschriebener Satz allein lehrt Bedeutung und Grammatik, doch die tatsächliche Zeile zu hören, mit Rhythmus, Betonung und Aussprache, lehrt, wie der Satz in echter Rede klingt. Das ist eine andere Fähigkeit als Leseverständnis, und Karteikarten ohne Ton können sie schlicht nicht aufbauen.
Videoausschnitte sind die aufwendigste Version dieser Vorlage und nicht für jede Karte nötig. Heben Sie sie für Sätze auf, deren visueller Kontext zählt, etwa Redewendungen, die an eine Geste oder einen Gesichtsausdruck gebunden sind, oder Dialoge, bei denen der Tonfall die Bedeutung ändert. Für gewöhnlichen Wortschatz decken Satz plus Ton plus Lückentext fast alles ab, was Sie brauchen.
Den Untertiteltext vor dem Kartenbau in saubere Satzeinheiten zu zerlegen verhindert außerdem einen häufigen Fehler: Karten aus unbeholfenen Fragmenten mitten im Satz. Jede Untertitelzeile als proportionalen Zeitabschnitt der ganzen Szene zu betrachten erleichtert es, Zeilen mit natürlicher Prosodie auszuwählen, solche, die tatsächlich wie etwas klingen, das ein Muttersprachler sagen würde, statt wie ein abgehacktes Fragment, das eine Timing-Regel zerteilt hat.
Manuelle Werkzeugkette oder integrierte App: was sollten Sie nutzen?
Stapelverarbeitung, Forschungsarbeit und detailliertes Neutiming verlangen wirklich nach einer manuellen Kette. Wenn Sie eine ganze Staffel auf einmal bearbeiten oder systematische Timingfehler in einer ganzen Datei beheben, geben Ihnen spezialisierte Extraktions- und Bereinigungswerkzeuge mehr Kontrolle.
Tägliches Mining ist jedoch eine andere Aufgabe. Wenn Sie fünf bis zehn Minuten haben und Wortschatz aus dem ziehen möchten, was Sie an dem Tag gerade sehen, schlägt ein integriertes Werkzeug, das Nachschlagen, Speichern und Kartenerstellung in einer Bewegung erledigt, das Jonglieren mit getrennten Apps. Entscheiden Sie nach Menge und Häufigkeit: Gelegentliche große Stapel sprechen für manuelle Werkzeuge, tägliches Lernen in kleinen Portionen für ein integriertes.
— Das WordByWord-Team
Starten Sie mit Untertiteln ohne die zusätzlichen Schritte
Subtitle Mining lässt sich mit Werkzeugen vereinfachen, die Extraktion, Bereinigung und Kartenerstellung zu einer einzigen Aktion im Browser bündeln. Statt eine Untertiteldatei zu ziehen, sie zu bereinigen und in eine separate SRS-App zu exportieren, erlauben manche Werkzeuge, Sätze mit Kontext direkt aus Videountertiteln zu speichern und zur Wiederholung einzuplanen.
Die Browser-Erweiterung arbeitet mit YouTube-Untertiteln, Websites und PDFs in über 50 Sprachen, sodass die Gewohnheit, die Sie an einem Video aufbauen, auf alles andere übergeht, was Sie lesen oder sehen. Manche Werkzeuge heben schon vor dem Ansehen hervor, welche Wörter bereits bekannt sind, und zeigen an, ob ein Inhalt zum Verständnisniveau passt.
Einige Sprachlernplattformen bieten kostenlose Tarife mit Nutzungslimits, mit denen sich der Ablauf des Subtitle Minings testen lässt, bevor man Premium-Tarife mit erweiterten Funktionen in Betracht zieht. Installieren Sie die Erweiterung fürs Sprachenlernen und bearbeiten Sie Ihr nächstes Video auf die einfache Art.
Quellen
- Subtitle Edit Rate (SubER) — ACL Anthology (2022)
- Geeklink
- subtools: Subtitle text analysis vignette — CRAN
Häufige Fragen
Was bedeutet „Sentence Mining“?
Sentence Mining bedeutet, ganze Sätze aus muttersprachlichen Inhalten zu ziehen, meist solche mit genau einem unbekannten Wort, und sie als Karteikarten zu speichern, statt isolierte Wortlisten zu lernen. Es bewahrt Kontext und persönlichen Bezug, und beides stärkt das Behalten im Vergleich zu allgemeinen Wortlisten.
Wie betreibt man Sentence Mining mit einem Browser-Werkzeug wie Yomitan?
Browserbasierte Nachschlagewerkzeuge lassen Sie ein unbekanntes Wort auf einer Webseite, in einem Videountertitel oder in einem Dokument anklicken und sofort eine Definition erhalten, die Sie dann zusammen mit dem ganzen Satz für die spätere Wiederholung speichern. WordByWord folgt demselben Prinzip für YouTube-Untertitel, PDFs und Websites und verbindet das Nachschlagen mit automatischer Kartenerstellung und Spaced-Repetition-Planung.
Was ist der Unterschied zwischen Softsubs und Hardsubs?
Softsubs sind separate Textspuren wie SRT- oder VTT-Dateien, die Sie direkt kopieren und bearbeiten können. Hardsubs sind ins Videobild selbst eingebrannt und brauchen eine Texterkennung, um in ein bearbeitbares Format überführt zu werden.
Wie viele Wörter sollte man pro Video sammeln?
Die meisten Lernenden erzielen mit einer moderaten Zahl neuer Wörter pro Sitzung stetige Ergebnisse, da größere Mengen die Spaced-Repetition-Pläne innerhalb einer Woche überlasten.
Warum sind Timingfehler in Untertiteln beim Mining wichtig?
Schlecht segmentierte oder falsch getimte Untertitel erzeugen oft unvollständige oder verstümmelte Sätze, aus denen sich schwerer lernen lässt. Metriken wie SubER wurden genau deshalb entwickelt, weil Timing und Segmentierung die Brauchbarkeit ebenso beeinflussen wie die Textgenauigkeit.